Dlaczego w ogóle myśleć o AI przy testach jednostkowych
Rosnący koszt ręcznego pisania i utrzymywania testów
W średnim lub dużym projekcie testy jednostkowe przestają być „dodatkiem”, a stają się istotnym kosztem. Godziny programistów idą nie tylko na tworzenie nowych testów, ale też na ich utrzymanie przy każdej zmianie logiki, refaktoryzacji i przebudowie architektury. Im dłużej żyje projekt, tym więcej czasu pochłaniają poprawki w istniejących testach, a nie ich tworzenie od zera.
Przy typowym rytmie sprintów bywa, że zespół cały czas „goni” pokrycie testami. Funkcjonalności są dowożone na styk, a na testy zostaje końcówka czasu. W efekcie testy są pisane na szybko, po macoszemu, albo w ogóle odkładane na „kiedyś” – co w praktyce oznacza: nigdy. Potem bugi z produkcji drogo się mszczą.
AI umożliwia przejęcie części żmudnej pracy: generuje szkielety testów, powtarzalne przypadki, proste dane wejściowe. Nie zastąpi to myślenia architektonicznego i rozumienia domeny, ale pozwala odzyskać kilka–kilkanaście godzin tygodniowo w zespole, jeśli proces zostanie rozsądnie poukładany.
Typowe problemy zespołów z testami jednostkowymi
W wielu zespołach powtarzają się bardzo podobne bolączki związane z testami jednostkowymi:
- brak czasu na systematyczne pisanie testów przy każdej zmianie kodu,
- niskie lub niespójne pokrycie kodu testami (różne moduły mają zupełnie inne standardy),
- nudne, ręczne dopisywanie podobnych testów dla kolejnych wariantów funkcji,
- brak konsekwencji w stylu testów (nomenklatura, wzorce Arrange–Act–Assert, struktura setupów),
- tendencja do testowania wyłącznie „happy path”, a ignorowania trudnych edge-case’ów.
W takim środowisku AI może zadziałać jak multiplier. Jeżeli zespół ma już podstawowy poziom kultury testowania, narzędzie pomoże domknąć luki: zaproponuje brakujące scenariusze, przypomni o przypadkach brzegowych, wygeneruje przykłady danych wejściowych dopasowane do sygnatury metody. Jeśli jednak testy są całkowicie chaotyczne, AI tylko przyspieszy produkcję kolejnego chaosu.
Jak AI może odciążyć programistów przy testach
Największy zysk z AI przy testach jednostkowych pojawia się wtedy, gdy narzędzie jest używane do pracy „w tle”, a nie jako magiczna różdżka. Kilka kluczowych zastosowań:
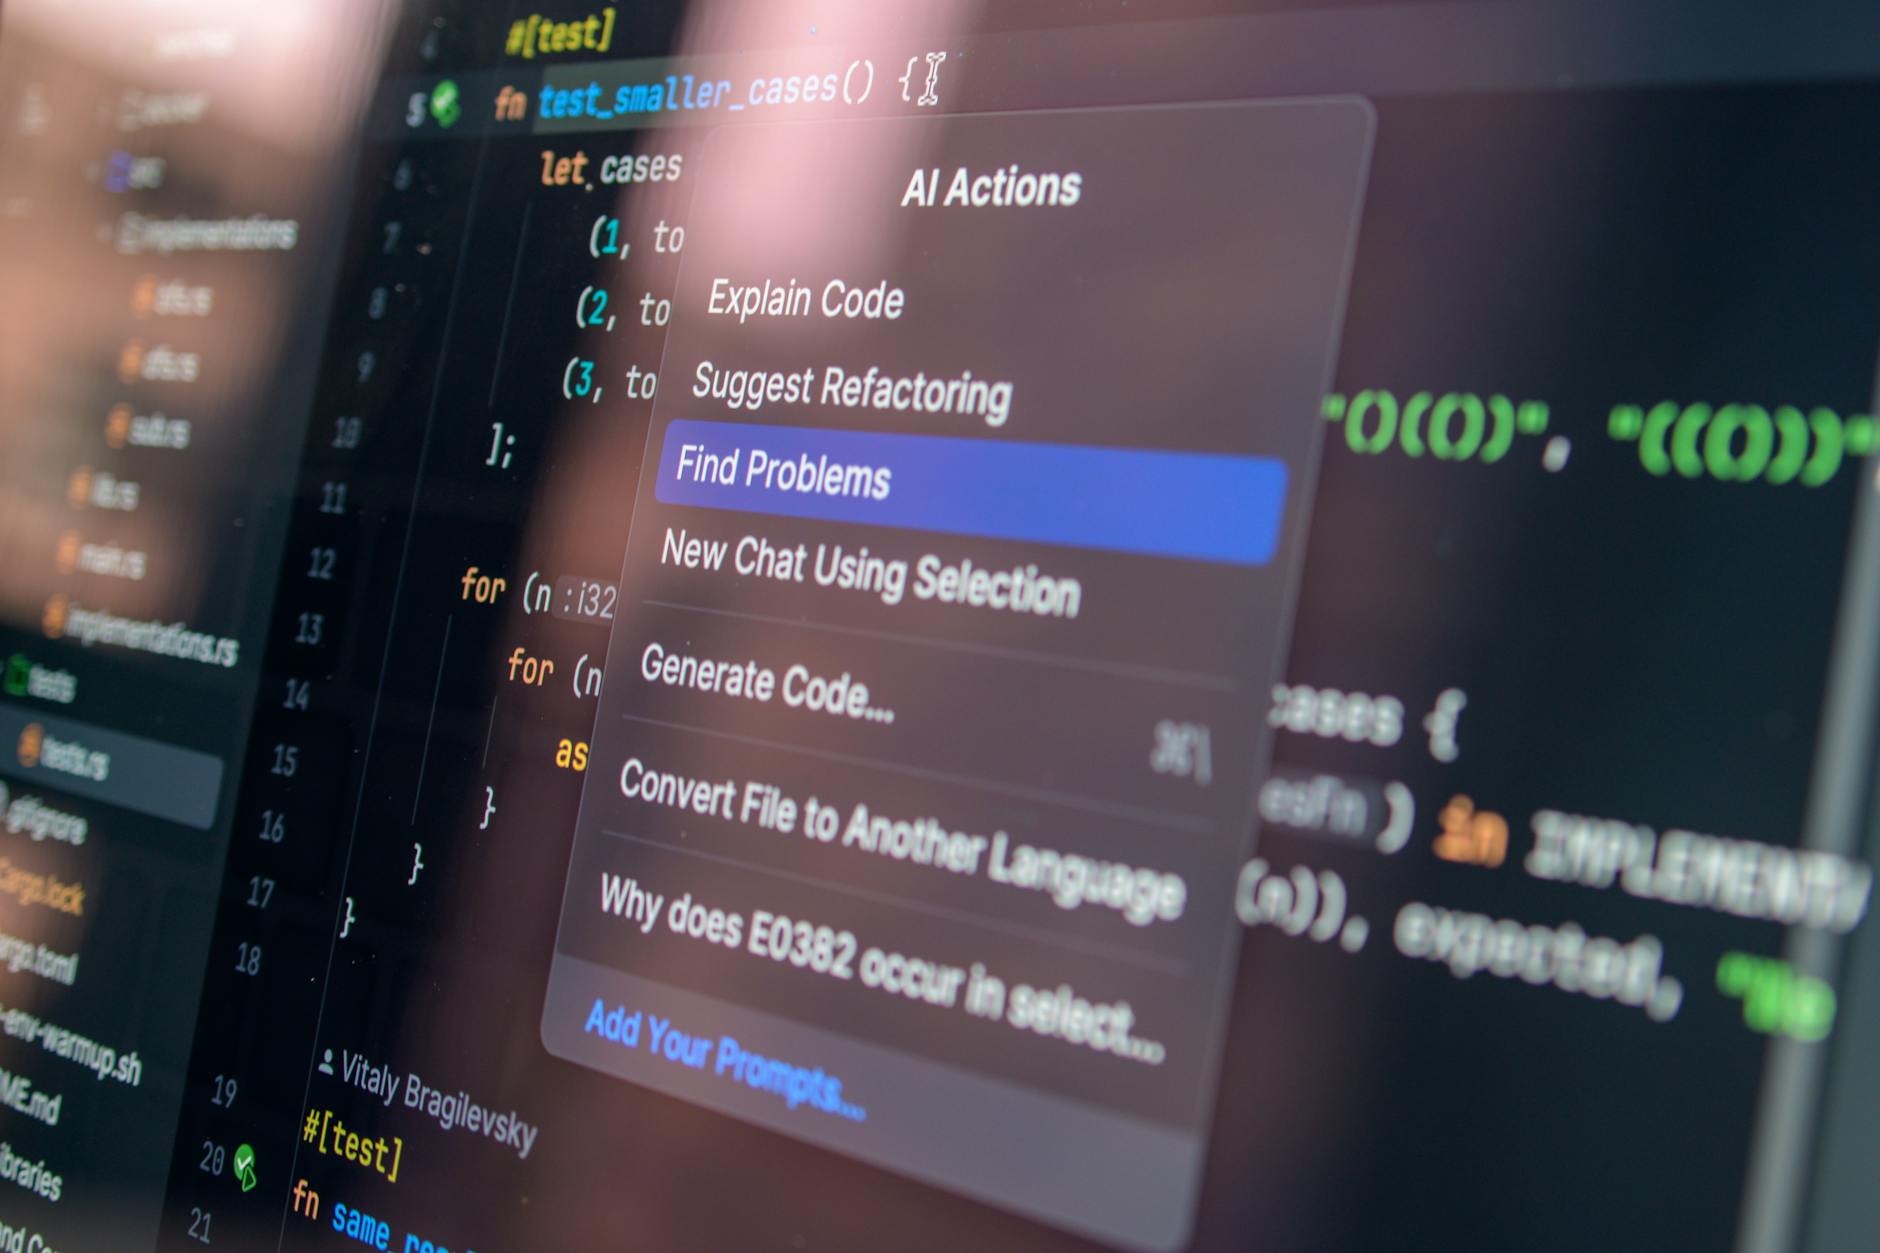
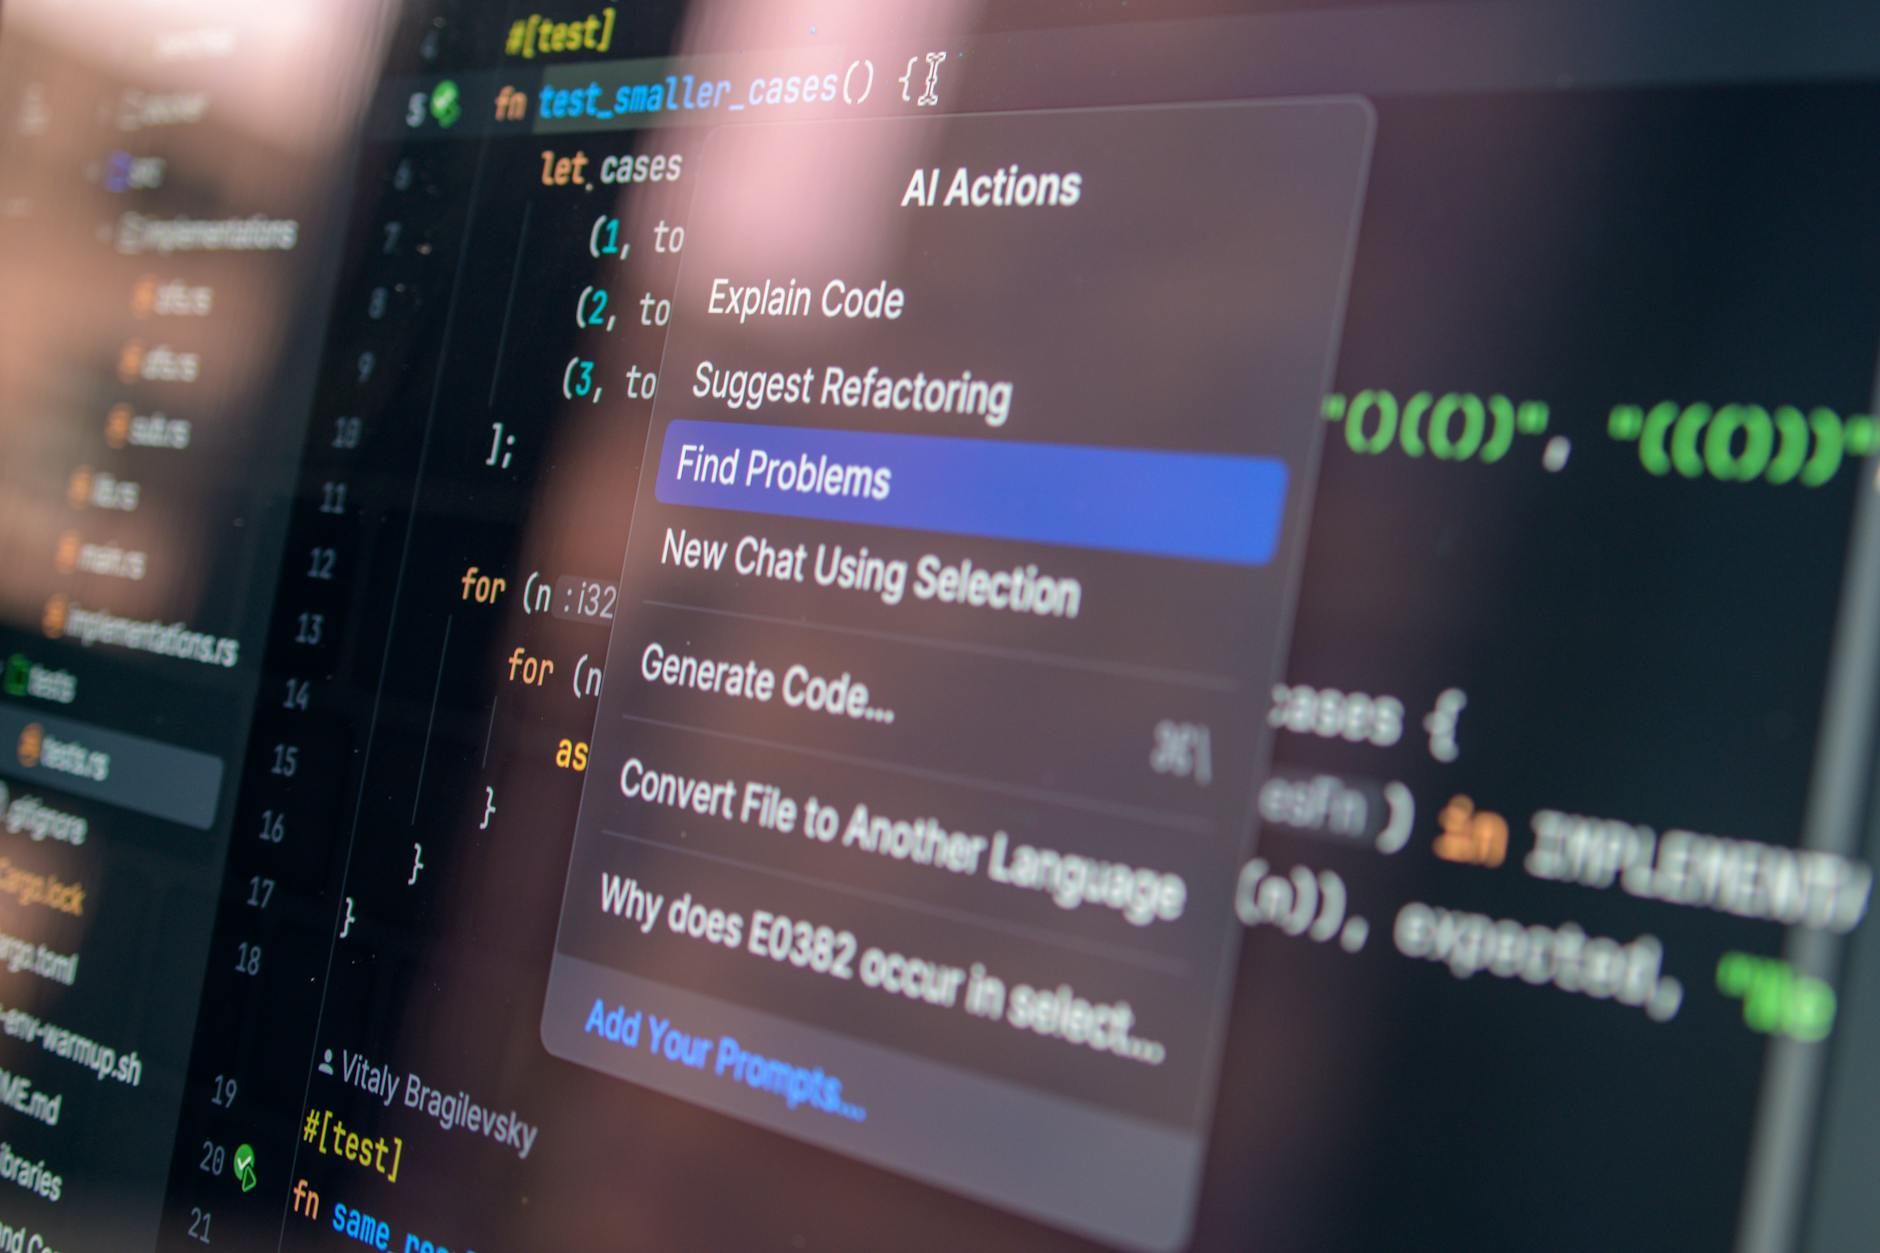
- Generowanie szkieletów testów – na podstawie funkcji, klasy lub fragmentu modułu, AI tworzy zarys testu: importy, setup, wywołanie kodu, proste asercje.
- Propozycje przypadków brzegowych – modele potrafią dobrze podsunąć: null/undefined, puste listy, wartości skrajne (min/max), nietypowe formaty danych itp.
- Refaktoryzacja istniejących testów – scalanie powielonego setupu, przeniesienie danych testowych do fixture’ów, uproszczenie złożonych asercji.
- Konwersja testów między frameworkami – zamiana na przykład Mocha → Jest lub JUnit 4 → JUnit 5, co ręcznie bywa dość mechaniczne i męczące.
W każdym z tych zastosowań AI oszczędza czas na czynnościach powtarzalnych, natomiast odpowiedzialność za sensowność samych testów pozostaje po stronie programisty.
„AI pisze za mnie” kontra „AI pomaga mi pisać szybciej i lepiej”
Największy błąd mentalny polega na traktowaniu AI jako zastępstwa, a nie asystenta. Jeśli oczekiwanie brzmi: „klikam przycisk i mam komplet testów jednostkowych”, to prędzej czy później projekt zostanie zasypany słabej jakości testami, których nikt nie rozumie i nikt nie chce utrzymywać.
Zdrowsze podejście to model, w którym programista:
- pisze lub projektuje kluczowe testy samodzielnie, na podstawie wymagań i znajomości domeny,
- korzysta z AI do szybkiego dociągnięcia powtarzalnych scenariuszy i przypadków brzegowych,
- traktuje wygenerowane testy jak szkic – coś, co wymaga przeglądu, poprawy nazw, czasem przepisania części asercji,
- włącza testy od AI w ten sam proces code review, co resztę kodu.
Tylko przy takim rozkładzie ról da się wykorzystać AI, jednocześnie nie tracąc kontroli nad projektem, architekturą testów i jakością całej bazy kodu.
Podstawy – co AI potrafi (a czego nie) przy testach jednostkowych
Kluczowe zastosowania AI do testów jednostkowych
Najprostszy poziom użycia to proszenie modelu: „napisz test jednostkowy dla tej funkcji”. W praktyce jednak można wycisnąć dużo więcej, jeśli podaje się sensowny kontekst.
Do typowych, przydatnych zastosowań należą:
- Podpowiedzi testów na podstawie funkcji – AI widzi sygnaturę metody, komentarze, czasem kontekst pliku i generuje kilka testów obejmujących główne ścieżki.
- Konwersja wymagań na testy – na bazie opisu zadania (ticket, user story) można poprosić o propozycje testów jednostkowych, które odzwierciedlają akceptowalne zachowania.
- Uzupełnianie asercji – jeśli w teście brakuje części sprawdzeń, AI może zasugerować dodatkowe oczekiwania, o ile kod i domena są czytelne.
- Generowanie danych testowych – tworzenie realistycznych obiektów, struktur JSON albo przygotowanie stubów odpowiedzi z zewnętrznych serwisów.
W wielu przypadkach najbardziej opłacalne jest używanie AI do generowania przykładowych danych wejściowych i testów dla „nudnych” wariantów. Wtedy programista skupia się na kilku kluczowych, bardziej złożonych scenariuszach.
Ograniczenia modeli generatywnych w kontekście testów
Modele językowe nie mają wbudowanej znajomości twojej konkretnej domeny i kodu. Widzą jedynie to, co dostają w promptcie i ew. w kontekście narzędzia (np. wtyczka IDE przegląda pliki). Z tego wynikają istotne ograniczenia:
- Halucynacje – AI może wymyślić nieistniejące metody, pola lub klasy, szczególnie gdy API jest nietypowe lub słabo opisane.
- Płytkie zrozumienie złożonej logiki – przy bardziej skomplikowanych regułach biznesowych model generuje testy dla prostych ścieżek, ignorując zależności czasowe, sekwencje zdarzeń lub specyficzne reguły branżowe.
- Brak wiedzy o szerszym kontekście – jeśli test ma uwzględniać interakcje między kilkoma modułami, a model widzi tylko jeden plik, testy mogą mijać się z rzeczywistością.
Dlatego AI jako autor testów „end to end” jest mało sensowne. Zdecydowanie lepiej sprawdza się jako narzędzie usprawniające lokalne testy jednostkowe i proste przypadki, gdzie logika jest relatywnie mało skomplikowana.
Ryzyko ślepego patrzenia na pokrycie kodu
Łatwo wpaść w pułapkę: „AI zrobiło mi 90% coverage, więc jesteśmy bezpieczni”. Pokrycie kodu, zwłaszcza linii, to tylko wskaźnik techniczny. Można mieć 95% coverage i wciąż nie mieć ani jednego testu dobrze opisującego kluczową regułę biznesową.
Automatyczne generowanie testów przez AI potrafi szczególnie zawyżać coverage poprzez:
- tworzenie wielu podobnych testów różniących się jedną wartością,
- testy, które tylko „przebiegają” przez kod bez realnych asercji,
- asercje sprawdzające rzeczy nieistotne z punktu widzenia domeny (np. konkretne komunikaty logów zamiast wyniku działania).
Pokrycie kodu warto traktować jako sygnał alarmowy (np. moduł bez testów), ale nie jako miarę jakości samą w sobie. Szczególnie w połączeniu z AI.
Jakie umiejętności programisty są konieczne
AI nie zdejmie odpowiedzialności za zrozumienie testowanego kodu. Żeby korzystanie z generowania testów miało sens i było bezpieczne, programista powinien:
- dobrze znać framework testowy używany w projekcie (JUnit, pytest, Jest, PHPUnit itd.),
- rozumieć różnice między testami jednostkowymi, integracyjnymi i systemowymi,
- umieć poprawić błędny test, a nie tylko go zaakceptować lub wyrzucić,
- znać podstawowe wzorce testów (Given–When–Then, Arrange–Act–Assert),
- mieć nawyk myślenia w kategoriach zachowań domenowych, a nie tylko mechaniki kodu.
Dopiero przy takim poziomie kompetencji AI staje się realnym przyspieszaczem, a nie generatorom śmieci, które trzeba później sprzątać z repozytorium.
Warunki brzegowe – kiedy AI do testów ma sens, a kiedy lepiej odpuścić
Projekty, gdzie AI daje największy zwrot z inwestycji
Nie w każdym systemie automatyzacja pisania testów przyniesie podobny efekt. W praktyce największy zwrot widać w projektach, gdzie logika jest względnie powtarzalna, a kodu jest dużo:
- Typowe serwisy CRUD – aplikacje biznesowe z wieloma podobnymi operacjami create/read/update/delete, walidacjami, mapowaniami DTO.
- Serwisy REST i mikroserwisy – powtarzalne endpointy, podobne schematy odpowiedzi, standardowe błędy (404, 400, 401, 500).
- Biblioteki narzędziowe – funkcyjne komponenty (np. parsowanie, transformacje danych), gdzie zachowanie można łatwo wyrazić przez wejście/wyjście.
W takich projektach AI świetnie radzi sobie z generowaniem serii testów dla podobnych przypadków, co normalnie zabrałoby sporo czasu. Duża część pracy ma charakter mechaniczny, więc opłaca się ją przekazać modelowi. Programista skupia się na wyjątkach, niestandardowych regułach i ważniejszych elementach architektury.
Systemy, gdzie nieostrożne użycie AI jest ryzykowne
Istnieją obszary, w których lekkomyślne poleganie na testach generowanych przez AI może być po prostu niebezpieczne:
- Systemy finansowe – zwłaszcza te, które obsługują rozliczenia, księgowość, przeliczenia walut, podatki; mały błąd w logice może mieć realne skutki prawne.
- Oprogramowanie medyczne – błędne testy mogą powodować, że nie zostaną wychwycone istotne problemy, mające wpływ na zdrowie pacjentów.
- Systemy bezpieczeństwa i kontroli dostępu – testy muszą uwzględniać scenariusze ataków, eskalacji uprawnień, luk w autoryzacji; AI może tego nie zauważyć.
- Złożone domeny eksperckie – np. systemy dla energetyki, telekomunikacji, logistyki, gdzie obowiązują skomplikowane reguły branżowe i przepisy.
W takich projektach AI da się wykorzystać, ale raczej do pomocniczych zadań: generowanie danych testowych, refaktoryzacja istniejących testów, podpowiadanie przypadków brzegowych. Projektowanie kluczowych testów powinno pozostać w rękach programistów dobrze znających domenę.
Jak ocenić, czy zespół jest gotowy na AI
Przed sięgnięciem po narzędzia generatywne dobrze jest szczerze odpowiedzieć na kilka pytań:
- Czy w projekcie istnieją już sensowne standardy testowania (konwencje, minimalne pokrycie, podział na typy testów)?
- Czy code review obejmuje również testy, a nie tylko kod produkcyjny?
- Czy pipeline CI jest stabilny, a testy faktycznie uruchamiają się przy każdym PR?
- Czy zespół ma choć kilka osób, które potrafią krytycznie ocenić jakość testów generowanych przez AI?
Jeśli większość odpowiedzi brzmi „nie”, w pierwszej kolejności lepiej zainwestować w uporządkowanie podstaw testowania. AI w takim środowisku byłoby tylko kolejnym źródłem złożoności i chaosu.
Przykład małego zespołu, który zyskał na użyciu AI
Typowy scenariusz z praktyki: kilkuosobowy zespół rozwija nowy mikroserwis odpowiedzialny za przetwarzanie zamówień. Terminy napięte, a jednocześnie wymagania biznesowe szybko się zmieniają. Pierwsze sprinty spędzili głównie na klejeniu logiki, testy jednostkowe odkładając na bok. Gdy przyszło do stabilizacji, okazało się, że coverage jest dramatycznie niski.
Zamiast zatrudniać osobnego testera automatyzującego, zespół sięgnął po AI zintegrowane z IDE. Wypracowali prosty proces: deweloper bierze moduł, pisze 2–3 kluczowe testy samodzielnie, a następnie prosi AI o wygenerowanie dodatkowych przypadków na bazie istniejących. Wszystkie testy przechodzą code review na równi z kodem.
Po kilku sprintach udało się podnieść pokrycie testami do poziomu akceptowalnego, przy stosunkowo małym narzucie czasowym. Zespół nie kupował drogich platform – korzystali z ogólnego modelu AI i lekkich skryptów w CI do raportowania coverage. Kluczowe było to, że nikt nie liczył, iż AI „magicznie” rozwiąże problem jakości; użyli go jako przyspieszacza pracy, a nie substytutu odpowiedzialności.
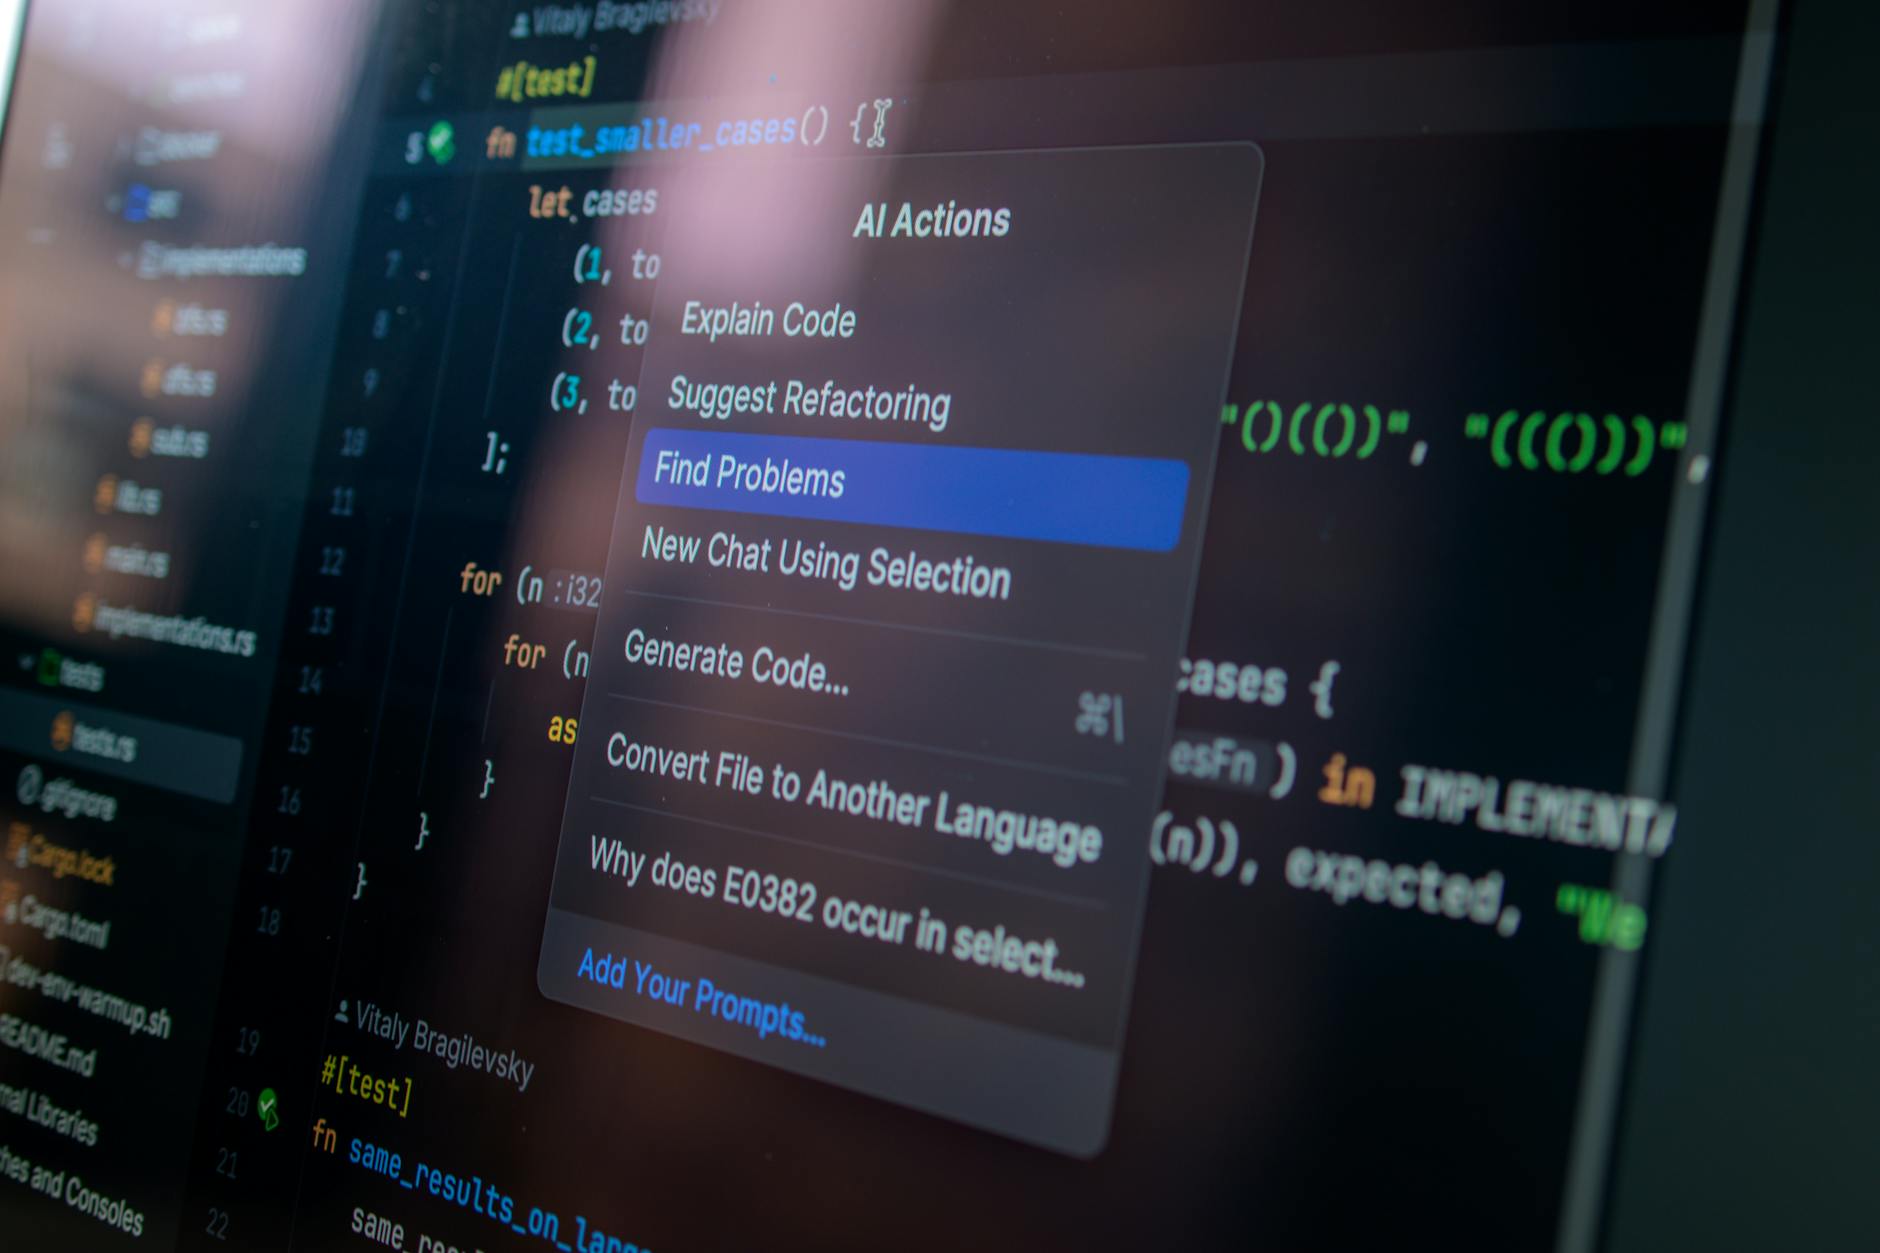
Wybór narzędzi – od darmowych wtyczek po komercyjne platformy
Podstawowe kategorie narzędzi wspierających testy z AI
Zanim pojawi się pierwsza faktura od dostawcy AI, dobrze rozróżnić główne typy rozwiązań. Każde uderza w inny fragment procesu testowania:
- Wtyczki do IDE – rozszerzenia do VS Code, IntelliJ, Ridera czy Visual Studio, które potrafią:
- podpowiadać szkielety testów dla wybranej klasy lub metody,
- generować asercje na podstawie istniejącego kodu,
- refaktoryzować zduplikowane testy.
Zaletą jest małe tarcie: deweloper nie musi wychodzić z edytora, a koszt wdrożenia to często kilka minut.
- Narzędzia linii komend (CLI) – skrypty lub małe narzędzia, które skanują repozytorium i na tej podstawie przygotowują pliki testów. Dobre, gdy chcemy „przepalić” większy fragment kodu i wygenerować pierwszą partię testów.
- Platformy SaaS – zewnętrzne systemy, które integrują się z GitHubem/GitLabem i działają w pipeline CI. Potrafią:
- proponować nowe testy w formie pull requestów,
- analizować pokrycie w kontekście zmian,
- wykrywać martwe lub redundantne testy.
To już wyższa półka – z reguły płatna i sensowna w większych organizacjach.
- Ogólne modele chatowe – narzędzia typu „chat z AI”, używane ręcznie przez dewelopera. Niby najmniej zautomatyzowane, ale bardzo elastyczne i często wystarczające na start.
Strategia „najpierw tanio i lokalnie”
Z perspektywy kosztów najbezpieczniej zacząć od dwóch rzeczy:
- darmowa lub tania wtyczka do IDE (nawet w wersji community),
- dostęp do uniwersalnego modelu AI, który poradzi sobie z kilkoma językami programowania.
Taka kombinacja pozwala przetestować użyteczność AI w projekcie bez wiązania się z jedną platformą. Jeśli po 2–3 sprintach nie widać realnej oszczędności czasu (szybsze dopisywanie testów, mniej nudnej pracy), inwestowanie w duże narzędzia nie ma sensu.
Na co patrzeć przy wyborze wtyczki do IDE
Zamiast kierować się marketingiem, lepiej sprawdzić kilka prostych kryteriów:
- Obsługiwane języki i frameworki – czy narzędzie rozumie
pytest,JUnit 5,RSpecalbo używany w projekcie test runner? Jeśli nie, generowane testy będą wymagały ciągłej ręcznej poprawy. - Jakość integracji z kodem – czy wtyczka widzi typy, zależności, adnotacje? Dobre narzędzie wykorzystuje informacje z projektu (np. typy generyczne, adnotacje walidacyjne), a nie tylko „czyta” pojedynczy plik.
- Możliwość konfiguracji stylu testów – nazewnictwo, konwencje, wzorce (Given–When–Then vs klasyczne
Arrange–Act–Assert). Im bliżej waszych standardów, tym mniej refaktoryzacji. - Lokalne uruchamianie czy wysyłka kodu w chmurę – kwestia bezpieczeństwa i zgodności z politykami firmy. W niektórych organizacjach odpadają wszystkie narzędzia przesyłające kod na zewnątrz.
Kiedy rozważyć komercyjną platformę
Płatne rozwiązania zaczynają się spinać biznesowo, gdy:
- zespół jest liczny, a koszt godzinowy programistów wysoki,
- projekt ma długą perspektywę utrzymania i stale rosnącą bazę testów,
- istnieje potrzeba audytowalności (raporty, historia zmian testów, integracja z ticketami).
Wtedy narzędzie, które automatycznie otwiera PR-y z propozycjami testów do nowych feature’ów, może realnie skrócić czas review i odciążyć seniorów. Nadal jednak dobrze, aby pierwsze eksperymenty zrobić na małym, wydzielonym module, a nie od razu na całym monolicie.
Ułożenie workflow – jak wpiąć AI w codzienne pisanie testów
Model „AI jako pierwszy szkic”
Najbardziej sensowny schemat w codziennej pracy przypomina pisanie tekstu: człowiek projektuje strukturę, AI przygotowuje draft, a potem człowiek edytuje. W świecie testów można to rozłożyć tak:
- Deweloper określa intencję testu – krótki komentarz lub opis w stylu: „walidacja zamówienia: odrzuć, jeśli brak adresu dostawy”.
- Na tej podstawie prosi AI o szkielet testu z podstawowymi asercjami.
- Dostosowuje dane wejściowe do realnych przypadków domenowych, usuwa zbędne szczegóły techniczne.
- Uruchamia testy, poprawia błędy i dopiero wtedy commituje.
AI nie podejmuje decyzji, co jest ważne – jedynie przyspiesza przejście od „pustego pliku” do sensownego szkicu.
Workflow przy pracy z pull requestami
AI dobrze działa także w momencie, gdy zmiana jest już gotowa i trzeba dopisać testy:
- Przed otwarciem PR deweloper uruchamia wtyczkę na zmodyfikowanych plikach i generuje propozycje testów.
- Do PR trafiają tylko te testy, które:
- jasno odwołują się do konkretnej reguły biznesowej,
- nie dublują istniejących przypadków,
- są zrozumiałe dla innych osób z zespołu.
- W trakcie review recenzent może sam użyć AI:
- do przeformułowania nieczytelnej asercji,
- do wygenerowania alternatywnego scenariusza testowego na bazie opisu.
Taki model ma jedną zaletę: zachowuje dotychczasowy rytm pracy (PR, review, CI), a AI jest tylko dodatkiem.
Podział ról w zespole
W większym zespole dobrze działa lekkie usystematyzowanie odpowiedzialności:
- „Właściciel standardów testów” – ktoś, kto pilnuje konwencji i raz na jakiś czas przegląda, jak AI wpływa na bazę testową (powtarzalne wzorce, antywzorce).
- „Eksperymentator AI” – osoba, która testuje nowe narzędzia / ustawienia modeli i dzieli się wnioskami, zamiast każdy bawił się tym samym w izolacji.
Nie musi to być formalny etat, raczej „czapka” na kilka godzin miesięcznie. Daje jednak jeden punkt kontaktu, jeśli narzędzie zaczyna generować problemy lub istnieje potrzeba zmiany konfiguracji.
Projektowanie sensownych testów – jak nie zgubić intencji biznesowej
Opis zachowania przed generowaniem testu
Najczęstszy błąd polega na tym, że deweloper zaznacza metodę i klika „wygeneruj testy”, bez żadnego opisu. Model widzi wtedy tylko sygnaturę i implementację, ale nie zna przyczyny powstania funkcji. Lepiej poprzedzić generowanie krótkim kontekstem, na przykład:
// Funkcja liczy rabat dla klienta B2B.
// Założenia biznesowe:
// - brak rabatu poniżej 1000 zł netto,
// - powyżej 1000 zł: 5%,
// - powyżej 5000 zł: 10%, chyba że klient jest nowy < 30 dni.
Później prompt do AI może wyglądać tak:
Na podstawie komentarza i kodu poniżej wygeneruj 3–5 testów jednostkowych
w pytest, pokazujących graniczne przypadki rabatów B2B.
Model dostaje wtedy nie tylko kod, ale i biznesowe założenia. Szansa, że testy skupią się na właściwych aspektach, rośnie wielokrotnie.
Utrzymywanie testów na poziomie „kontraktów”
Test generowany przez AI ma tendencję do przyklejania się do implementacji, np. sprawdzania konkretnych nazw metod pomocniczych czy struktury wewnętrznych obiektów. To zjada elastyczność przy refaktoryzacji. Dobry wzorzec to formułowanie testów jako kontraktów:
- „Dla takich danych wejściowych ten komponent gwarantuje taki wynik” – testuje się zachowanie, nie budowę klasy.
- „Po wywołaniu tej operacji stan magazynu jest zaktualizowany w taki sposób” – nie interesuje nas, czy to zrobiła jedna metoda, czy pięć.
Przy review testów pochodzących z AI dobrym filtrem jest pytanie: „Czy ten test opisuje biznes, czy szczegóły implementacji?”. Jeśli to drugie – test nadaje się do uproszczenia lub wyrzucenia.
Ograniczanie „szumu” w generowanych testach
Modele mają skłonność do nadprodukcji. Zamiast kilku celnych testów pojawia się kilkanaście wariacji, które niewiele wnoszą. Kilka prostych zasad pomaga trzymać to w ryzach:
- W promptach używać sformułowań typu „maksymalnie 5 testów” i doprecyzować, że mają pokrywać tylko scenariusze brzegowe.
- Prosić: „Nie generuj testów, które różnią się wyłącznie jedną liczbą bez zmiany zachowania.”
- Po wygenerowaniu przejrzeć listę i zostawić tylko te, które dodają nową informację o systemie – resztę od razu usuwać, zamiast odkładać na później.
Przykład przeprojektowania testu z perspektywy domeny
Często opłaca się wziąć test wygenerowany przez AI i przepisać jego opis oraz nazwy tak, by były zrozumiałe dla biznesu. Zamiast:
test_calculate_discount_returns_zero_for_small_amount()lepsze będzie:
test_b2b_client_without_minimum_order_does_not_receive_discount()Sam kod asercji może w dużej części pochodzić z AI, ale nazwa i komentarz powinny jasno wskazywać regułę biznesową. To niewielki koszt, a ogromna różnica przy późniejszym debugowaniu i onboardingu nowych osób.
Kontrola jakości – jak sprawdzać testy generowane przez AI
Code review testów jako reguła, nie wyjątek
Najprostszy i najtańszy mechanizm bezpieczeństwa to traktowanie testów z AI identycznie jak kod produkcyjny. Kilka pytań, które powinny paść w każdym review:
- Czy test ma jasny, zrozumiały cel, opisany w nazwie i ewentualnie komentarzu?
- Czy asercje faktycznie sprawdzają biznesowe zachowanie, a nie przypadkowe szczegóły?
- Czy przypadkiem nie testuje się kilku niezależnych rzeczy w jednym teście?
- Czy test jest stabilny (brak zależności od czasu, losowości, kolejności uruchamiania), jeśli nie jest to świadomie zaprojektowane?
Na początku w review można nawet oznaczać w PR, które testy zostały zainicjowane przez AI. Pozwala to szybciej wyłapać powtarzające się problemy i poprawić sposób korzystania z narzędzia.
Metryki jakości testów zamiast samego coverage
Pokrycie liniowe mówi mało. Taniej i skuteczniej jest dodać kilka prostych wskaźników jakości:
- Odsetek testów bez asercji – każdy taki przypadek powinien być z miejsca oznaczony jako błąd (wiele narzędzi do analizy statycznej potrafi to wykryć).
- Średnia długość testu – skrajnie długie testy (np. 200+ linii) generowane przez AI to często znak, że trzeba je rozbić na mniejsze przypadki.
- Stosunek testów ignorowanych/skipped – jeśli w repozytorium pojawia się masa
@Ignore/@Disabled, to znak, że AI wygenerowało coś, czego nikt nie miał odwagi usunąć.
Takie proste metryki można wprowadzić jako część pipeline CI, używając darmowych narzędzi lub lekkich skryptów, bez inwestowania w rozbudowane platformy analityczne.
Wykrywanie „fałszywego bezpieczeństwa”
Najtrudniej walczyć z sytuacją, gdy testy przechodzą, ale nie łapią realnych błędów. Dwa tanie mechanizmy pomagają to ograniczyć:
- Celowe wstrzykiwanie błędów – raz na jakiś czas senior wprowadza drobną, kontrolowaną zmianę w logice (np. odwrócenie warunku, zmiana progu) w osobnej gałęzi i sprawdza, czy testy ją wykryją. Jeśli nie – wracamy do projektowania przypadków testowych.
- Analiza regresji po incydentach – gdy bug trafi na produkcję, pierwsze pytanie brzmi: „Dlaczego nasze testy tego nie złapały?”. Często okazuje się, że AI wygenerowało wiele technicznych testów, ale zabrakło jednego prostego scenariusza biznesowego.
Przycinanie i porządkowanie bazy testów
Po kilku miesiącach używania AI baza testów ma tendencję do puchnięcia. Regularne „sprzątanie” jest tańsze niż utrzymywanie śmieci przez lata:
- Raz na kwartał przejrzeć moduły o największej liczbie testów i sprawdzić, które są:
- zduplikowane (testują to samo przy innych liczbach),
Automatyczne sygnały ostrzegawcze w CI
Sprzątanie testów jest mniej bolesne, jeśli część pracy wykona za nas pipeline. Nie trzeba od razu kupować rozbudowanych platform – często wystarczy kilka skryptów i linijek konfiguracji:
- Alert na gwałtowny przyrost liczby testów – prosty skrypt porównujący liczbę testów z poprzednim commitem. Jeśli przy jednym PR liczba testów rośnie o kilkadziesiąt procent, to sygnał: AI mogło „przepisać świat”. Warto wtedy zrobić dokładniejsze review.
- Blokada na testy bez asercji – grep + prosty parser potrafią wyłapać funkcje testowe bez słów kluczowych typu
assert,expect,should. Taki test nie przechodzi CI, dopóki ktoś nie uzasadni jego istnienia. - Limit długości pliku testowego – narzędzia pokroju
cloclub prosty skrypt w Pythonie/Node pozwalają oznaczyć pliki testów przekraczające np. 500 linii. Nie trzeba ich blokować, ale można dodać ostrzeżenie w logach lub komentarz bota w PR.
Takie „taniochy” zwracają się przy pierwszym większym regresyjnym sprzątaniu, które uda się dzięki nim uniknąć.
Rola testów integracyjnych i end-to-end jako bezpiecznika
AI generuje przede wszystkim testy jednostkowe, ale to nie one łapią wszystkie problemy. Dobrze jest mieć cienką, ale celnie dobraną warstwę testów integracyjnych i E2E, która stanowi dodatkowy bezpiecznik:
- 2–3 scenariusze „od frontu do bazy” dla kluczowych przepływów (zamówienie, płatność, rejestracja), pisane ręcznie przez zespół.
- Testy kontraktowe między serwisami, które pilnują, żeby zmiana wymuszona przez AI w jednym module nie rozjechała się z resztą systemu.
AI można tu wykorzystać wyłącznie pomocniczo: do szkicu selektorów w UI, propozycji danych testowych czy setupu środowiska. Decyzja, które przepływy pokryć, pozostaje po stronie ludzi – inaczej łatwo uzyskać setki technicznych testów E2E i dalej nie sprawdzać kluczowych ścieżek biznesowych.
Weryfikacja testów na poziomie danych wejściowych
Cichy błąd w testach wygenerowanych przez modele to zbyt „grzeczne” dane. Testy przechodzą, bo system dostaje idealne, dobrze sformatowane wejścia. Opłaca się dodać etap, w którym ktoś patrzy wyłącznie na dane wykorzystywane w testach:
- Czy są przypadki pustych stringów, nulli, wartości ujemnych, ekstremalnie dużych liczb?
- Czy pojawiają się dane niepoprawne biznesowo (np. data w przyszłości, gdy model logiki na to nie pozwala)?
- Czy testy pokrywają typowe pomyłki użytkownika (literówki w mailu, niepełny adres, brakujące pola)?
Tu AI też może pomóc – można poprosić model: „Na podstawie poniższych testów zaproponuj 5 dodatkowych zestawów danych wejściowych, które mogłyby złamać założenia funkcji, ale nie są pokryte istniejącymi przypadkami.”. Gotowe dane wkleja się następnie do istniejących testów, zamiast generować kolejne funkcje testowe.
Prosty proces „ratowania” błędnych testów
Kiedy AI wprowadzi test, który blokuje pracę (fałszywie czerwony) lub przepuszcza poważny błąd, pojawia się pokusa, żeby go po prostu wyłączyć adnotacją. Lepszy jest krótki, jasny proces:
- Ktoś oznacza test jako „podejrzany” w PR lub issue, dopisując 1–2 zdania, co jest nie tak (np. „test zależy od kolejności wywołań w mocku, nie od wyniku biznesowego”).
- Senior lub „właściciel standardów testów” decyduje: naprawiamy czy kasujemy. Żadnych półśrodków w stylu
@Disabledna stałe. - Jeśli test został skasowany, wchodzi zasada: „zostaw po sobie coś lepszego” – w to samo miejsce dodaje się prostszy, stabilny test, który sprawdza tę samą regułę.
Ten proces da się opisać na pół strony w wiki i powiesić jako checklistę w opisie PR. Dzięki temu baza testów nie zamienia się w cmentarzysko wyłączonych przypadków, których nikt się nie chce ruszyć.
Edukacja zespołu na przykładach z produkcji
Najlepszym „trenerem” korzystania z AI przy testach są realne wpadki. Zamiast suchych warsztatów można raz na jakiś czas przejść przez kilka incydentów z produkcji i odpowiedzieć na dwa pytania:
- Jakie testy mogłyby ten błąd złapać (i czy AI byłoby w stanie je wygenerować przy dobrym promptcie)?
- Które z istniejących testów wprowadziły fałszywe poczucie bezpieczeństwa?
Przykładowo: błąd w naliczaniu VAT dla jednego kraju UE wyszedł dopiero w księgowości. Analiza pokazuje, że AI wygenerowało kilkanaście testów dla ogólnej funkcji
calculate_tax, ale żaden nie dotykał konkretnego kraju z niestandardową stawką. Wniosek jest prosty – trzeba poprawić opis domeny w promptach i dodać listę szczególnych przypadków, które zawsze muszą się znaleźć w testach.Rozsądne limity „mocy” AI w projekcie
Żeby nie stracić kontroli nad projektem, można jawnie ustalić limity stosowania AI przy testach. Kilka przykładów reguł, które działają w praktyce:
- „AI może generować szkice testów, ale nie mergujemy niczego, co zostało wklejone 1:1 bez edycji człowieka.”
- „Dla modułów krytycznych biznesowo (płatności, limity kredytowe) AI służy tylko do przygotowania danych testowych i refaktoryzacji istniejących testów, nie do pisania nowych od zera.”
- „Jeżeli w jednym PR więcej niż 70% nowych testów pochodzi z AI, senior musi zrobić dodatkowy, merytoryczny review pod kątem zgodności z domeną.”
Takie zasady są tanie we wdrożeniu, a jasno pokazują, że modele są narzędziem wspierającym, a nie automatycznym generatorem jakości.
Iteracyjne dopasowywanie promptów do projektu
Jakość testów generowanych przez AI w dużej mierze zależy od promptów. Zamiast liczyć na „magiczne” jedno polecenie, lepiej podejść do tego iteracyjnie:
- Zebrać 3–5 przykładów promptów, które faktycznie wygenerowały użyteczne testy (np. z historii PR) i dodać je do repozytorium jako
PROMPTS.md. - Co parę tygodni uaktualniać te przykłady na bazie tego, co działało przy realnych zmianach.
- Unikać ogólników typu „wygeneruj testy jednostkowe”, a zamiast tego stosować wzorce:
- „Skup się na przypadkach brzegowych dla reguły X i Y…”
- „Testy mają odzwierciedlać te scenariusze biznesowe: …”
- „Pisz w stylu istniejących testów w pliku X, zachowując nazewnictwo i strukturę.”
Po kilku iteracjach zespół ma zestaw sprawdzonych „zaklęć”, które znacząco zwiększają jakość tego, co wypluwa model, bez konieczności kupowania kolejnego narzędzia.
Ostrożne użycie generatywnych poprawek w istniejących testach
Coraz więcej narzędzi oferuje automatyczne „naprawianie” testów – model dostaje błąd z CI i proponuje poprawkę. To ogromna oszczędność czasu, ale też ryzyko, że test zostanie „wyciszony” zamiast naprawiony. Kilka prostych reguł bezpieczeństwa:
- Gdy AI proponuje zmianę asercji, koniecznie trzeba sprawdzić, czy znaczenie testu się nie zmieniło (np. z „powinno rzucić wyjątkiem” na „powinno zwrócić null”).
- Każda automatyczna poprawka powinna być opisana w PR jednym zdaniem: „Ten test był fałszywie czerwony, bo…”. Zmusza to do chwili refleksji.
- Jeśli poprawka polega na dodaniu
await, timeoutu lub innego „kleju”, dobrze jest dopisać dodatkowy, prosty test, który sprawdza samą logikę bez zależności asynchronicznych.
Da się w ten sposób wykorzystać wygodę automatycznych poprawek, nie zamieniając testów w losowo przechodzący zbiór zaklęć.
Zarządzanie kosztami korzystania z komercyjnych modeli
W projektach, gdzie używane są płatne modele, rachunki za generowanie testów potrafią nieprzyjemnie zaskoczyć. Kilka prostych trików pomaga trzymać koszty w ryzach:
- Ustalony limit: np. „AI generuje testy tylko dla plików zmienionych w PR, nie dla całych modułów naraz”. To ogranicza gigantyczne prompty z historią projektu.
- Preferowanie tańszych modeli przy prostych zadaniach (refaktoryzacja, zmiana nazewnictwa) i włączanie droższych tylko przy bardziej złożonych fragmentach logiki.
- Ponowne użycie promptów i kontekstu – zamiast za każdym razem wklejać całą specyfikację rabatów B2B, lepiej trzymać ją w osobnym pliku i podawać skrócony opis + link do dokumentu, który zna zespół.
Efekt uboczny jest pozytywny: mniejsze prompty i lepsze zawężenie zakresu działania modelu zwykle poprawiają też jakość generowanych testów.
Ustalanie „mapy krytyczności” testów
Nie wszystkie testy są równie ważne. Jeśli AI ma pomóc, a nie przejąć stery, dobrze jest jawnie określić, które obszary są „ręczne z definicji”, a gdzie można dać modelom więcej swobody:
- Dla funkcji typu helpery stringów, formatowanie dat, prosta walidacja – większość testów może spokojnie pochodzić z AI, przy minimalnej korekcie.
- Dla logiki związanej z pieniędzmi, uprawnieniami, zgodnością prawną – AI nie pisze testów bezpośrednio. Może natomiast pomagać w doprecyzowaniu scenariuszy lub przygotowaniu danych.
- Dla obszarów legacy, których nikt już dobrze nie rozumie – AI może być użyte do odkrywania obecnych zachowań (snapshoty, golden files), ale decyzja, co z tym zrobić, leży po stronie ludzi.
Taka mapa może mieć formę prostego dokumentu lub nawet komentarzy w kodzie na poziomie pakietów. Ułatwia nowym osobom zrozumienie, czemu w jednym miejscu AI jest mile widziane, a w innym – ledwie tolerowane.
Stopniowe rozszerzanie lub cofanie zakresu użycia AI
Na koniec ważny aspekt organizacyjny: nie trzeba od razu decydować, że „od dziś wszystko testujemy z AI” albo „u nas AI jest zakazane”. Rozsądniejsze podejście to małe eksperymenty z jasnymi kryteriami:
- Wybrać jeden moduł lub zespół, gdzie AI będzie aktywnie wykorzystywane przez 2–3 sprinty.
- Zmierzony zostaje czas spędzony na pisaniu testów, liczba regresji i ogólny komfort pracy zespołu.
- Jeżeli eksperyment przynosi korzyści – zasady są kopiowane do kolejnych obszarów. Jeśli nie – zakres użycia AI się ogranicza albo zmienia sposób pracy z modelami (inne prompty, inne narzędzia).
Dzięki temu AI pozostaje kolejnym narzędziem w skrzynce, a nie religią, którą trzeba wyznawać niezależnie od kosztów i efektów.
Najczęściej zadawane pytania (FAQ)
Czy AI może samodzielnie napisać wszystkie testy jednostkowe w projekcie?
AI może wygenerować bardzo dużo testów, ale jeśli oddasz mu pełną kontrolę, skończysz z masą przypadkowych, trudnych w utrzymaniu plików. Modele nie rozumieją dobrze twojej domeny biznesowej ani kontekstu architektury, więc nie wyłapią niuansów, które są kluczowe dla jakości systemu.
Zdrowszy model to podejście „AI jako asystent”: programista projektuje kluczowe testy, a AI dopisuje powtarzalne warianty, proste scenariusze i szkielety. Dzięki temu zespół oszczędza godziny na nudnej pracy, ale nie traci kontroli nad tym, co jest faktycznie testowane.
Jak konkretnie użyć AI do przyspieszenia pisania testów jednostkowych?
Najprostszy sposób to podanie funkcji lub klasy i poproszenie o „testy jednostkowe z przykładami edge-case’ów”. Model wygeneruje szkielety: importy, setup, wywołanie kodu i podstawowe asercje. Taki szkic można potem szybko dopracować ręcznie.
Dobrze działa też:
- konwersja wymagań (ticket, user story) na listę testów jednostkowych,
- prośba o zestaw danych testowych (np. różne struktury JSON, puste listy, wartości skrajne),
- refaktoryzacja istniejących testów – ujednolicenie stylu, wyciągnięcie powtarzalnego setupu do fixture’ów.
W praktyce największy zysk daje zlecanie AI „nudnych” wariantów, a skupianie ludzkiej pracy na kluczowych ścieżkach biznesowych.
Jakie są największe ryzyka korzystania z AI przy testach jednostkowych?
Najczęstszy problem to halucynacje: AI potrafi wymyślić metody, pola albo całe klasy, których w projekcie nie ma. W efekcie powstają testy, które nie kompilują się lub działają, ale testują coś zupełnie nieistotnego. Drugi typ ryzyka to płytkie pokrycie logiki – model skupia się na prostych ścieżkach i „happy path”, omijając złożone reguły.
Dodatkowo łatwo nadmuchać pokrycie kodu bez realnej wartości: wiele prawie identycznych testów, asercje oparte na detalach implementacyjnych czy logach. Żeby tego uniknąć, każdy test wygenerowany przez AI powinien przejść normalne code review, a zespół musi umieć ocenić, czy test faktycznie zabezpiecza ważne zachowanie systemu.
Jak nie stracić kontroli nad projektem, korzystając z AI do testów?
Klucz to jasny podział ról. Programiści:
- samodzielnie projektują testy dla krytycznych funkcji i reguł biznesowych,
- używają AI do dopisania wariantów, case’ów brzegowych i powtarzalnych scenariuszy,
- traktują wynik AI jako szkic, który trzeba nazwać, uprościć lub częściowo przepisać.
Wszystko, co wygeneruje AI, trafia w ten sam proces przeglądu, co reszta kodu.
Dobrym, tanim zabezpieczeniem jest prosta zasada: „żaden test z AI nie wchodzi bez zrozumienia przez autora i reviewera, co dokładnie sprawdza”. To minimalny narzut, a chroni przed lawiną śmieciowego kodu testowego.
Czy AI pomoże zwiększyć pokrycie testami bez marnowania czasu?
AI potrafi szybko „podbić” pokrycie linii kodu, ale to jeszcze nie oznacza lepszej jakości. Najkorzystniej używać go do znalezienia ewidentnych dziur – modułów, gdzie brakuje podstawowych przypadków, szczególnie edge-case’ów, wartości skrajnych, pustych kolekcji itp.
Sensowny, oszczędny workflow wygląda tak: najpierw ludzie definiują kilka kluczowych scenariuszy dla modułu, później AI generuje dodatkowe testy i dane wejściowe. Zespół odrzuca testy „bez zębów” (brak istotnych asercji) i zostawia te, które faktycznie dokładają nowe zachowania. W efekcie pokrycie rośnie, ale bez mnożenia nic niewnoszących plików.
Jakie umiejętności musi mieć programista, żeby bezpiecznie używać AI do testów?
AI nie zastąpi rozumienia kodu. Programista powinien dobrze znać używany framework testowy (np. JUnit, pytest, Jest, PHPUnit), rozróżniać testy jednostkowe od integracyjnych i systemowych oraz swobodnie poprawiać błędne testy zamiast je bezrefleksyjnie akceptować.
Przydaje się też znajomość prostych wzorców (Arrange–Act–Assert, Given–When–Then) i nawyk myślenia o zachowaniach domenowych, a nie o samych linijkach kodu. Bez tego AI tylko przyspieszy produkowanie bałaganu – testy będą liczne, ale mało przydatne.
Jakie narzędzia AI do testów jednostkowych wybrać na start przy ograniczonym budżecie?
Na początek wystarczy prosty setup: wtyczka AI w IDE (np. Copilot‑podobne narzędzia, często dostępne w wersjach trial lub tańszych planach) oraz dostęp do modelu, który dobrze radzi sobie z kodem. Na małe i średnie zespoły zwykle nie ma sensu inwestować w drogie, wyspecjalizowane platformy, jeśli podstawowa kultura testów dopiero raczkuje.
Dobry, budżetowy plan:
- uruchomić AI w IDE dla 1–2 osób w zespole,
- wypracować prosty workflow generowania i review testów,
- dopiero po kilku sprintach, jeśli widać realne oszczędności czasu, rozszerzyć licencje na resztę.
Pozwala to zminimalizować koszty, a jednocześnie szybko sprawdzić, czy AI faktycznie odciąża zespół przy pisaniu testów.
Najważniejsze punkty
- Ręczne pisanie i utrzymywanie testów jednostkowych w większych projektach staje się istotnym kosztem – AI pomaga zbić ten koszt, przejmując żmudne, powtarzalne fragmenty pracy.
- Największy zysk z AI pojawia się tam, gdzie testy już istnieją i mają podstawowy porządek; wtedy narzędzie domyka luki (edge-case’y, dane wejściowe, powtarzalne scenariusze), zamiast produkować dodatkowy chaos.
- AI jest najbardziej użyteczne do generowania szkieletów testów, propozycji przypadków brzegowych, refaktoryzacji istniejących testów oraz konwersji między frameworkami – czyli dokładnie tam, gdzie praca jest mechaniczna i mało kreatywna.
- Rolą programisty pozostaje projektowanie kluczowych testów na podstawie wymagań i domeny, a wygenerowane testy traktuje się jako szkic wymagający przeglądu, dopracowania nazw i asercji oraz normalnego code review.
- Model „AI pisze za mnie wszystkie testy” prowadzi do bazy słabych, niezrozumiałych testów trudnych w utrzymaniu; rozsądniejsze jest użycie AI jako przyspieszacza, który skraca nudną część pracy, ale nie podejmuje decyzji za zespół.
- AI dobrze radzi sobie z prostymi ścieżkami i typowymi wzorcami (null, puste listy, skrajne wartości), ale nie zna specyfiki twojej domeny, więc przy złożonej logice biznesowej potrzebna jest ręczna weryfikacja i uzupełnienie scenariuszy.
- Najbardziej opłacalny wariant „na start” to wykorzystanie AI do generowania danych testowych i testów dla prostych wariantów, tak aby programista mógł skupić swój czas na kilku krytycznych, trudnych przypadkach zamiast na masowej produkcji podobnych testów.